
Strings kompakt: Python-Strings sind unveränderliche Unicode-Sequenzen. Dieses Kapitel behandelt Indizierung, Slicing, wichtige Stringmethoden, Vergleiche, Escape-Sequenzen sowie die Grenze zwischen str und bytes.
Python-Kurs
Strings
Einführung
Text wird in Python mit Objekten des Typs str dargestellt. Ein String ist eine unveränderliche Sequenz von Unicode-Codepoints. Python besitzt keinen separaten Zeichentyp; die Indizierung eines Strings liefert wiederum einen String der Länge 1.
Für Binärdaten gibt es dagegen bytes und bytearray. Die Umwandlung zwischen Text und Bytes erfolgt explizit durch Kodieren (text.encode(...)) und Dekodieren (daten.decode(...)).

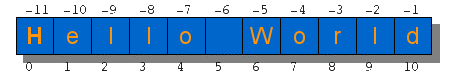
Jedes einzelne Zeichen eines Strings, kann über einen Index angesprochen werden. Im folgenden Beispiel sehen wir, wie der im Bild dargestellte String in Python definiert wird und wie wir auf ihn zugreifen können:
s = "Python"
print("Der erste Buchstabe: ", s[0])
print("Der vierte Buchstabe", s[3])
Die Länge eines Strings kann man mit der Funktion len() bestimmen und damit kann man auch einfach beispielsweise auf das letzte oder vorletzte Zeichen eines Strings zugreifen:
s = "Python"
index_last_char = len(s) - 1
print(s[index_last_char])
print(s[index_last_char - 1])
Da es bei der praktischen Arbeit sehr häufig vorkommt, dass man auf einzelne Zeichen eines Strings von hinten zugreifen muss, wäre es sehr lästig, wenn man dies immer über den Umweg durch den Aufruf der Funktion len() machen müsste. Python bietet deshalb eine elegantere Möglichkeit. Die Indices werden auch von rechts durch negative Indices nummeriert, d.h. das letzte Zeichen wird mittels des Index -1, das vorletzte mittels -2 usw. angesprochen. Wir sehen dies in der folgenden Abbildung veranschaulicht:

Im Code sieht dies wie folgt aus:
s = "Python"
last_character = s[-1]
print(last_character)
Ganz allgemein sieht ein String also so aus:
Bisher haben wir unsere Strings immer durch doppelte Anführungszeichen vorne und hinten begrenzt. Es gibt jedoch auch andere Möglichkeiten.
Strings können auch auf folgende Arten erzeugt werden:
- einzelnen Anführungszeichen ('): 'Dies ist ein String mit einfachen Quotes'
- doppelten Anführungszeichen (") "Mayers' Dackel heißt Waldi"
- drei einfache (''') oder drei doppelte (""") Anführungszeichen: '''String in drei doppelten oder drei einfachen Anführungszeichen können auch über mehrere Zeilen gehen und 'einfache' und "doppelte Anführungszeichen enthalten.'''
Wichtige Stringoperationen
- Konkatenation:
"Hello" + "World"ergibt"HelloWorld". - Wiederholung:
"*-*" * 3ergibt"*-**-**-*". - Indexing:
"Python"[0]ergibt"P". - Slicing:
"Python"[2:4]ergibt"th". - Länge:
len("Python")ergibt6. - Mitgliedschaft:
"th" in "Python"istTrue.
Strings sind unveränderlich. Methoden wie replace(), upper() oder strip() liefern daher neue Strings und verändern den ursprünglichen String nicht.
== statt is für Stringvergleiche
== vergleicht Stringwerte. is prüft Objektidentität und darf nicht verwendet werden, um Stringinhalte zu vergleichen. Ob zwei gleiche Stringliterale aufgrund von Interning zufällig dasselbe Objekt sind, ist ein Implementierungsdetail.
a = "Baden-Württemberg"
b = "".join(["Baden", "-", "Württemberg"])
print(a == b)       # Wertvergleich
print(a is None)    # 'is' ist für Identitätsfragen gedacht
Für None und andere bewusst als Singleton verwendete Objekte ist ein Identitätsvergleich passend, z. B. wert is None. Für Textinhalte verwendet man == bzw. !=.
Escape-Sequenzen und Raw Strings
In Stringliteralen leitet der Backslash \\ Escape-Sequenzen ein. Häufige Beispiele sind:
\\n– Zeilenumbruch\\t– horizontaler Tabulator\\r– Wagenrücklauf\\\\– ein Backslash\\'bzw.\\"– Anführungszeichen\\xhh– Zeichen über einen zweistelligen Hexwert\\uXXXXund\\UXXXXXXXX– Unicode-Codepoints\\N{name}– Unicode-Zeichen über seinen Namen
Mit dem Präfix r entstehen Raw Strings, bei denen Backslashes weitgehend wörtlich behandelt werden, beispielsweise r"C:\\Users\\name". Auch Raw Strings haben einige syntaktische Besonderheiten; insbesondere können sie nicht mit einer einzelnen ungeraden Anzahl von Backslashes enden.
Unicode und Bytes
str enthält Unicode-Text. encode() wandelt einen String mit einer angegebenen Zeichenkodierung in bytes um; decode() führt die umgekehrte Operation durch.
s = "الكلب"
print(s)
b = bytes(s, 'utf-8')
print(b)
b1 = s.encode()
print(b1 == b)

s = "σκύλος"
b = bytes(s, 'utf-8')
print(b)
Bytes werden mit der passenden Zeichenkodierung wieder zu Text dekodiert. Bei decode() ist UTF-8 der Default, eine explizite Angabe kann die Absicht aber klarer machen:
print(str(b, 'utf-8'))
print(b.decode())
Schauen Sie sich 'help(str)' und 'dir(str)' an und experimentieren Sie mit den Funktionen und Methoden. Insbesondere "find" und "strip".